VISÃO COMPUTACIONAL · REGISTRO HISTÓRICO PESSOAL
Quatro terabytes.
Uma responsabilidade humana.
Descritores, classificadores, redes neurais e o custo de procurar evidências com os recursos de 2010–2011.
Klyff Harlley Toledo · Novembro de 2010 · Curitiba, Paraná
Relato pessoal e discussão científica de técnicas. As figuras quantitativas são cenários analíticos reproduzíveis, sem dados do acervo histórico.
Baixar suplemento Python ↓Índice · 22 seções
- 1. Antes do primeiro vetor, havia pessoas e discos
- 2. O laboratório que existia — e o futuro que ainda não existia
- 3. Preservar o que chegou antes de interpretar o que aparece
- 4. Da observação autorizada ao fluxo de bytes
- 5. ZIP dentro de RAR dentro de outro contêiner: o problema recursivo
- 6. A rede paralela como ambiente de análise, não como réplica do mundo externo
- 7. “Parece uma imagem” ainda é uma hipótese de formato
- 8. Quatro terabytes: o relógio da pesquisa tinha som de HDD
- 9. Fazer a imagem caber em uma representação
- 10. Distância, normalização e o que o número realmente compara
- 11. Treinar um classificador não era escrever uma regra para cada fotografia
- 12. O conjunto de dados começa nas decisões humanas
- 13. Conteúdo, idade, identidade e conclusão são perguntas distintas
- 14. CNNs: representação aprendida e orçamento de operações
- 15. Margem, probabilidade e abstenção
- 16. Quando 95% de sensibilidade ainda produz uma fila ruim
- 17. A fila humana é um recurso finito
- 18. Registro pessoal: 2012 e 2022
- 19. Um procedimento verificável, sem revelar a implementação reservada
- 20. O que veio depois — cronologia separada
- 21. Suplemento analítico para executar em casa
- 22. Conclusão: reduzir a busca e conservar a dúvida
Resumo
Este artigo examina o problema computacional e humano de organizar uma cadeia de triagem de imagens no enfrentamento da exploração sexual de crianças, no contexto dos meus estudos de mestrado, em Curitiba, entre 2010 e 2011. O ponto de partida é um acervo de aproximadamente 4 TB recebido em discos rígidos, sob procedimentos de entrega e responsabilidade junto à Polícia Federal, e o problema complementar de recuperar objetos a partir de fluxos de rede submetidos a observação autorizada. O método é decomposto em preservação, reconstrução de fluxos, reconhecimento de formatos, abertura controlada de contêineres, decodificação, descrição visual, classificação, calibração e revisão humana. A discussão distingue descritores locais e globais, classificadores estatísticos e redes convolucionais disponíveis no período; separa processamento em CPU, limites de memória e custos de armazenamento; e explicita por que um limiar de score não determina idade, autoria, identidade ou conclusão pericial. Sete conjuntos de figuras e tabelas reproduzíveis ilustram custos analíticos e distribuições matemáticas. Fotografias minhas de 2012 e 2022 contextualizam a variação de aparência ao longo de dez anos, sem comparação biométrica. O objetivo é documentar técnicas e decisões científicas, sem divulgar o acervo, a implementação completa, pessoas sob investigação ou informação protegida.
Palavras-chave: visão computacional; proteção de crianças; triagem forense; descritores; CPU; SIFT; SURF; HOG; SVM; convolução; calibração; cadeia de custódia.
Abstract
This article records the technical reasoning behind a 2010–2011 computer-vision problem in child protection: preserving and processing a multi-terabyte image corpus, recovering files from authorized network evidence, and organizing an auditable review pipeline under CPU, memory and storage constraints. It separates file integrity, image decoding, feature extraction, statistical scoring and human forensic interpretation. Analytical figures and generated score distributions illustrate engineering tradeoffs rather than historical benchmark results. No sensitive corpus, explicit imagery or biometric comparison is published.
1. Antes do primeiro vetor, havia pessoas e discos
Eu era um entusiasta de inteligência artificial fazendo mestrado. A ideia de ensinar uma máquina a perceber padrões era fascinante. O problema que apareceu, porém, não tinha a leveza de uma demonstração de laboratório: envolvia imagens cuja análise podia ser necessária para proteger crianças e apoiar o trabalho de investigação. A motivação científica era inseparável da responsabilidade pelo que estávamos tentando enfrentar.
No meu relato daquele trabalho, a Polícia Federal entregava o material e havia documentos a assinar. O volume que me marcou foi de aproximadamente 4 TB de fotografias em HDDs: vários discos, pesados, lentos, contendo imagens previamente organizadas que precisariam ser convertidas em conjuntos de trabalho para classificação. Não apresento aqui a relação desses discos, a origem de cada arquivo ou a documentação reservada. O número contextualiza o desafio material; não é uma autorização para redistribuir o conteúdo.
Era preciso ter estômago. Mas a resposta profissional não podia ser romantizar a exposição nem transformar sofrimento em curiosidade técnica. Eu precisava reduzir visualizações desnecessárias, controlar quem acessava o quê e construir um método que ajudasse as pessoas responsáveis pela análise, em vez de simplesmente multiplicar a quantidade de imagens que elas teriam de ver.
Havia duas frentes que precisavam conversar sem se confundir. A primeira era o acervo recebido em mídia. A segunda era o tratamento de fluxos de informação de entrada e saída associados a sujeitos cuja observação estivesse formalmente dentro do escopo de uma investigação. Um arquivo recebido em disco não tem a mesma procedência técnica que um objeto recomposto de tráfego. Um relatório confiável deve preservar essa diferença desde a origem.
O trabalho duro começava antes da inteligência artificial. Eu precisava demonstrar qual material tinha sido recebido, o que havia sido copiado, o que estava completo, o que não era decodificável e quais transformações tinham sido feitas para análise. Depois disso, ainda faltava lidar com a pergunta visual. E a pergunta visual não era uma só.
imagem decodificável ≠ conteúdo corretamente interpretado
score elevado ≠ idade demonstrada ≠ conclusão pericial
Esta é a tese que organiza o artigo. A máquina pode ajudar a reduzir uma busca, ordenar uma fila e apontar incerteza. Ela não pode transformar um indício estatístico em certeza simplesmente porque o software terminou de executar.
2. O laboratório que existia — e o futuro que ainda não existia
Para falar de 2010, eu preciso resistir à tentação de inserir retrospectivamente as ferramentas de uma década depois. O nome de uma arquitetura moderna não torna mais rigorosa a explicação do que era possível naquele momento. Também seria incorreto afirmar que redes convolucionais ou representações aprendidas ainda não existiam.
| Técnica / família | Referência temporal | Posição neste registro |
|---|---|---|
| SVM e florestas aleatórias | 1995 / 2001 | Classificadores disponíveis antes do recorte |
| Redes convolucionais / LeNet | 1998 | Aprendizagem de características já demonstrada; domínio e escala importam |
| SIFT | Artigo de referência de 2004 | Descritor local compatível com o período |
| HOG | 2005 | Gradientes e normalização local; não é detector de abuso ou de idade |
| SURF | 2006 | Pontos de interesse e aproximações eficientes |
| ORB | 2011 | Evolução em nota de continuidade; não ferramenta de novembro de 2010 |
| AlexNet | 2012 | Comparação posterior sobre escala e aceleração |
| ResNet | Preprint de 2015; CVPR 2016 | Evolução posterior |
| ViT | Preprint de 2020; ICLR 2021 | Evolução posterior |
| CLIP | 2021 | Evolução posterior; não ferramenta do mestrado de 2010 |
Uso SIFT para Scale-Invariant Feature Transform. Se a sigla pretendida for IFT, Image Foresting Transform, trata-se de outra família, baseada em caminhos e florestas em grafos de imagem, com aplicações em segmentação e outras tarefas; não é uma abreviação alternativa de SIFT. Essa distinção evita misturar métodos porque os nomes se parecem. [1]
No vocabulário do trabalho, eram naturais expressões como descritor, vetor de características, espaço de características e representação. Um vetor aprendido por PCA ou por uma rede também pode ser uma representação latente. “Latente” não significa “latência”: uma coisa é uma variável não observada diretamente, outra é o tempo de resposta do sistema. A oposição correta não é “antigamente havia vetores, hoje há embeddings”; é quais características eram projetadas manualmente, quais eram aprendidas e sob quais restrições.
No inventário prático entravam C/C++, bibliotecas de visão, operações vetoriais, ferramentas de prototipação e serviços de armazenamento. OpenCV já tinha sua linha 2.0 no período de 2009–2010; LIBSVM possuía versões anteriores a 2010; OpenMP 3.0 tinha especificação de 2008. Isso tornava viáveis protótipos e paralelismo em CPUs, sem significar que a instalação de uma biblioteca resolvia procedência, dados ou validação. [2] [3] [4]
“Majoritariamente em CPU” descreve uma restrição de projeto discutida aqui, não uma afirmação de que GPUs não existiam. Elas já eram usadas em pesquisa de redes no período. Uma nota de 2011 sobre CNNs em GPU ajuda a demarcar essa evolução; não a uso para inventar uma placa, um cluster ou um tempo de treinamento que eu não tenha apresentado neste registro. [5]
3. Preservar o que chegou antes de interpretar o que aparece
A unidade científica não é apenas uma imagem JPEG exibida na tela. É o objeto acompanhado de procedência: mídia ou fluxo de origem, identificação interna do caso, instante de aquisição, versão do procedimento, integridade, transformações e relação com os resultados. Retirar a imagem desse contexto pode destruir justamente a informação necessária para avaliar sua interpretação.
Eu separaria o original preservado da cópia de trabalho. A cópia de trabalho pode originar uma miniatura, uma versão normalizada, um vetor ou um índice. Nenhuma dessas derivações substitui o original. Uma conversão aparentemente inocente pode modificar metadados, orientação, perfil de cor ou conteúdo de pixels. O sistema precisa registrar a transformação, e não chamar todas as versões simplesmente de “a foto”.
id_derivação = H(id_objeto ∥ configuração ∥ versão_ferramenta ∥ saída)
registro = {origem, objeto_pai, operação, parâmetros, estado, responsável}
O hash permite verificar igualdade de bytes sob as propriedades do algoritmo; não prova que a imagem seja verdadeira, não identifica uma vítima e não demonstra quem a produziu. Um arquivo pode ter integridade criptográfica e representar uma montagem. Um arquivo incompleto pode receber um hash perfeitamente calculado. Integridade e completude precisam de campos diferentes.
O NIST SP 800-86, publicado em 2006, organiza princípios de aquisição, exame, análise e relato para resposta a incidentes. Ele é uma referência técnica de organização, não substituto dos procedimentos e requisitos específicos de uma investigação da Polícia Federal. Uso essa fronteira para não apresentar um guia de TI como se fosse automaticamente uma norma jurídica de cadeia de custódia. [6]
No catálogo de evidências, eu guardaria estados explícitos: recebido, copiado, verificado, incompleto, contêiner reconhecido, conteúdo cifrado, limite de expansão atingido, imagem válida, derivação criada, descritor produzido e revisão pendente. Um erro do parser não deveria virar silenciosamente “conteúdo negativo”. Ele é um resultado técnico próprio, que precisa permanecer rastreável.
4. Da observação autorizada ao fluxo de bytes
O ingresso de dados de rede deve começar pelo escopo autorizado e pela identificação técnica de uma sessão, não por uma suposição ampla de que todo tráfego de uma rede pertence a uma pessoa. Endereços, portas e horários ajudam a descrever observações; NAT, equipamentos compartilhados, sessões remotas e outros intermediários limitam a atribuição individual. Eu não trataria um endereço IP como uma identidade civil.
O primeiro nível é a preservação da captura e do seu contexto: ponto de coleta, relógio, direção observada, identificador de sessão e perdas conhecidas. “Entrada” e “saída” precisam ser definidas em relação ao ponto de observação. Não são propriedades universais de um pacote. Um buffer saturado ou uma interface incapaz de acompanhar a taxa pode perder dados antes de qualquer algoritmo de imagem entrar em ação.
No TCP, números de sequência permitem colocar os bytes no espaço correto, lidar com retransmissões e detectar lacunas; a simples ordem em que pacotes aparecem em uma captura não é a ordem final de um arquivo. O RFC 793, de 1981, é a referência histórica para esses conceitos. Tráfego incompleto deve continuar marcado como incompleto, inclusive quando parte do objeto parece legível. [7]
cobertura = união dos intervalos observados
lacunas = intervalo esperado − cobertura observada
Depois da reconstrução de transporte, ainda há enquadramento de aplicação: mensagens podem conter cabeçalhos, múltiplos objetos, codificações e fragmentos. Um limite de pacote não é um limite de arquivo. Só concatenar payloads e procurar um marcador de JPEG é insuficiente para afirmar que um objeto foi recuperado corretamente.
Outra fronteira não pode ser apagada: tráfego cifrado não se torna imagem apenas por ter sido capturado. Sem acesso legítimo ao conteúdo em claro e ao contexto necessário, o sistema registra a limitação. Não há aqui um procedimento para contornar criptografia, credenciais ou autorização. A análise começa onde existe material tecnicamente disponível dentro do escopo permitido.
O resultado dessa etapa deve ser um candidato a objeto com origem e qualidade de reconstrução, não uma acusação sobre o sujeito observado. Múltiplos objetos podem surgir de uma sessão, e múltiplos níveis de transformação podem existir entre a sessão e a imagem. Essas relações são preservadas como uma árvore de derivação.
5. ZIP dentro de RAR dentro de outro contêiner: o problema recursivo
Uma extensão de arquivo é uma indicação, não uma prova. Um nome terminado em .jpg pode não conter uma imagem; um nome sem extensão pode conter uma imagem válida. Eu começaria pela identificação de estrutura e assinatura, aplicaria o parser correspondente e validaria o resultado com limites de memória e tempo. A validação não termina no primeiro marcador de cabeçalho.
| Formato / família | Questão de processamento | Estado necessário |
|---|---|---|
| ZIP | Múltiplas entradas, compressão, nomes, diretório e possíveis entradas cifradas | Entrada processada, recusada, incompleta ou inacessível |
| RAR | Variações de versão, volumes e dependência de ferramenta compatível | Versão reconhecida e volumes disponíveis |
| 7Z | Compressão sólida, dependência entre entradas e possível cifragem | Custo de expansão e acesso ao conteúdo registrados |
| GZ | Compressão de um fluxo; pode envolver um TAR ou outra estrutura | Fluxo descomprimido ainda precisa ser identificado |
| TAR | Agregação de entradas; não significa compressão por si só | Tipos e caminhos de entradas avaliados antes de materializar |
| “FIR” ou formato não identificado | A sigla isolada não determina um formato ou parser | Desconhecido; identificação adicional necessária |
GZIP tem uma especificação histórica própria no RFC 1952, de 1996. Distinguir compressão de agregação evita, por exemplo, confundir um .tar.gz com uma pasta que já estivesse pronta após uma única operação. O catálogo de preservação da Library of Congress descreve características do 7z, incluindo compressão sólida e cifragem; essa consulta serve para esclarecer o contêiner, não para atribuir ao sistema histórico suporte a toda versão posterior. [8] [9]
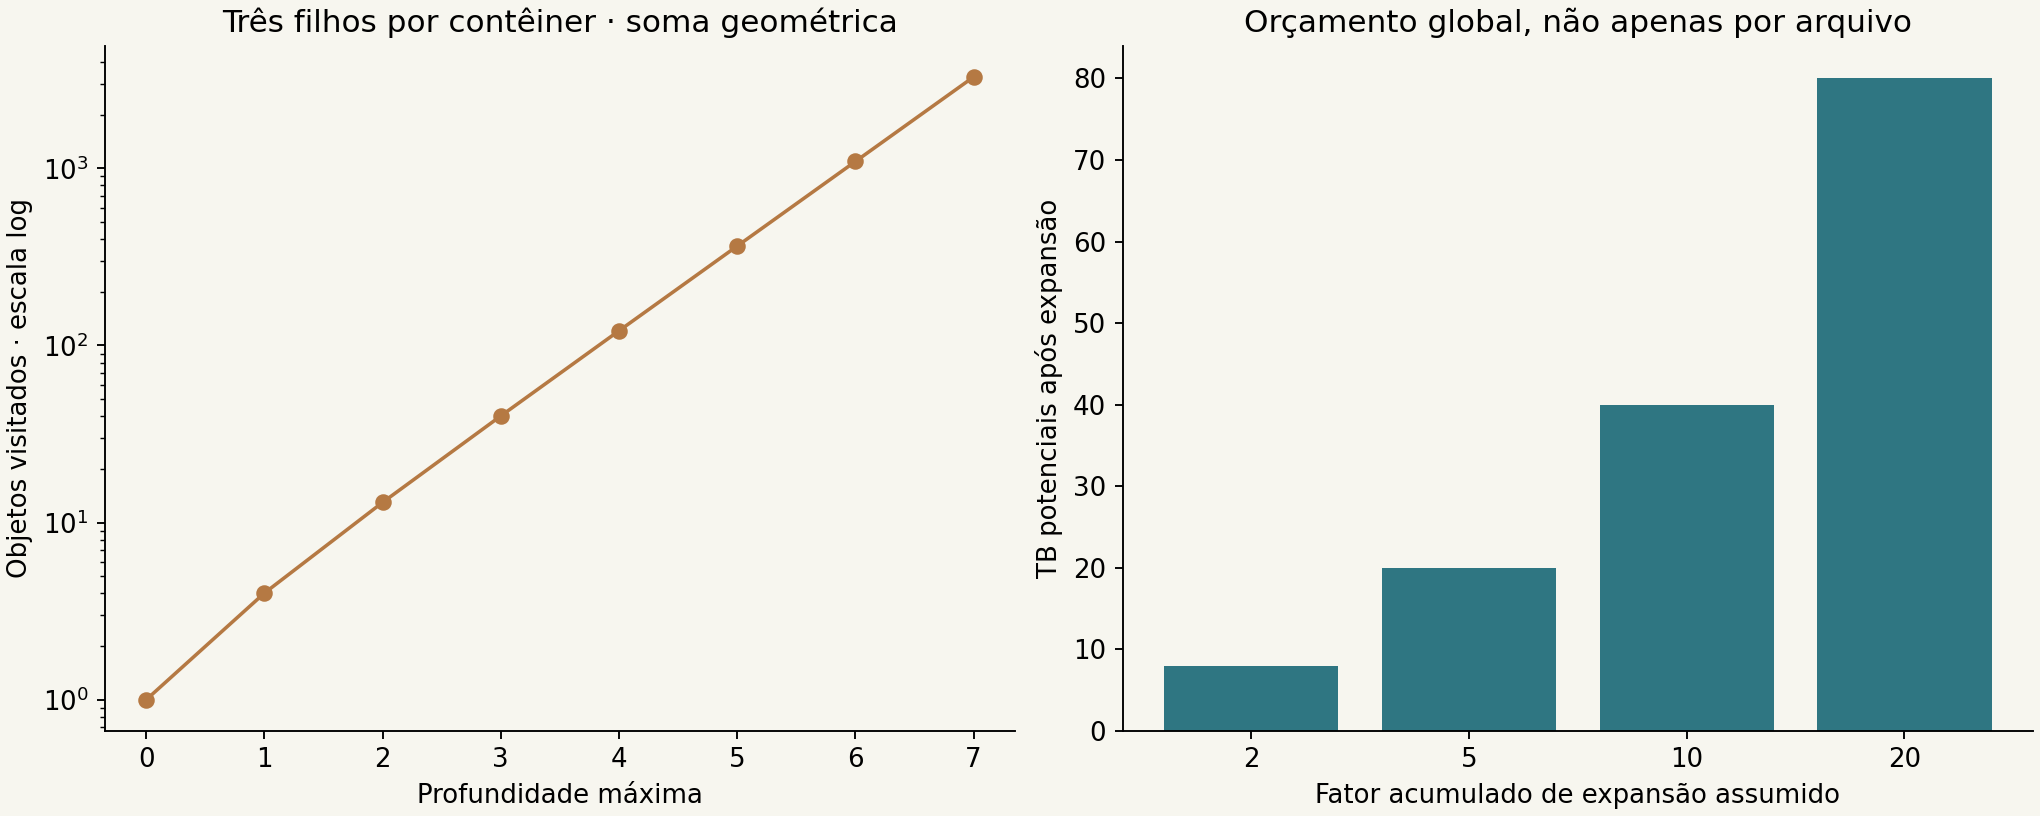
A recursão precisa de orçamento global. Limitar cada entrada isoladamente não impede que milhares de entradas pequenas consumam toda a máquina. Eu definiria profundidade máxima, total de bytes expandidos por árvore, quantidade de objetos, limite de pixels por imagem e tempo por ferramenta. Entradas que ultrapassam o orçamento são encaminhadas a tratamento controlado; não são classificadas como irrelevantes.
N(d,b) = Σᵢ₌₀ᵈ bⁱ = (b^(d+1) − 1)/(b − 1), para b ≠ 1
aceitar_expansão ⇔ profundidade ≤ d_max ∧ B_total ≤ B_max
∧ objetos ≤ N_max ∧ tempo ≤ T_max
Com três filhos por contêiner, sete níveis de profundidade já implicam 3.280 objetos visitados, contando a raiz. O crescimento vem da árvore, não do tamanho do primeiro cabeçalho. Os limites de orçamento precisam viajar com a tarefa quando ela muda de processo ou máquina; reiniciar o contador a cada processo anula a proteção.
O trabalhador que abre contêineres não deve executar os arquivos encontrados, seguir links ou escrever fora da área permitida. Nomes relativos e caminhos absolutos precisam de tratamento próprio antes de qualquer materialização. Arquivos cifrados, volumes faltantes, formatos não suportados e imagens enormes exigem estados diferentes. “Não consegui abrir” não é o mesmo que “não havia nada a analisar”.
6. A rede paralela como ambiente de análise, não como réplica do mundo externo
O ambiente separado precisa permitir examinar os bytes sem executar a intenção contida neles. Quando falo em reconstruir em uma rede paralela, descrevo um laboratório isolado de trabalho: uma cópia controlada dos objetos e das relações necessárias para análise. Não seria sensato reproduzir automaticamente acessos, autenticações, comandos ou comunicações do material observado.
Os originais permanecem preservados. Trabalhadores de extração e decodificação recebem entradas identificadas e devolvem saídas declaradas. O processo que transforma um JPEG em matriz não precisa de acesso à rede de investigação, a credenciais de outras ferramentas ou à internet. Essa redução de privilégios torna uma falha de parser mais contida e a execução mais reproduzível.
Eu separaria filas por custo e risco operacional: identificação de arquivo, expansão de contêiner, decodificação, derivação visual e extração de características. Uma tarefa é idempotente quando repeti-la com o mesmo objeto e configuração não cria decisões contraditórias ou duplica contagens silenciosamente. O identificador da tarefa deve incorporar a configuração; mudar a resolução de análise produz outra derivação.
resultado = {estado, hashes_de_saída, tempo, memória, motivo_de_falha}
reprocessar ≠ sobrescrever a história anterior
Uma fila limitada oferece backpressure: se a decodificação não acompanha a extração, o sistema reduz o ingresso em vez de transformar toda a RAM em buffer. Retentativas precisam de limite e motivo. Um arquivo que falha repetidamente não pode circular para sempre entre trabalhadores, consumindo o tempo destinado ao restante do acervo.
7. “Parece uma imagem” ainda é uma hipótese de formato
Depois do cabeçalho, eu verificaria se a estrutura permite percorrer o arquivo, se as dimensões são plausíveis dentro do orçamento e se um decodificador compatível produz uma matriz válida. Uma miniatura incorporada não demonstra que a imagem principal esteja completa. Um arquivo parcialmente legível pode revelar algum conteúdo e ainda precisar de marcação de truncamento.
Uma imagem comprimida pequena pode declarar dimensões que exigiriam memória enorme. Para RGB de 8 bits, a matriz básica ocupa aproximadamente W × H × 3 bytes. Ao convertê-la em ponto flutuante de 32 bits, passam a ser W × H × 3 × 4 bytes, antes de gradientes, pirâmides, buffers de convolução ou cópias de bibliotecas.
M_RGB32F = W H × 3 × 4 bytes
4.000 × 3.000 × 3 × 4 = 144.000.000 bytes ≈ 137,3 MiB
Dezesseis imagens desse porte já ocupariam aproximadamente 2,15 GiB apenas nas matrizes RGB em float32. Uma biblioteca que cria temporários pode duplicar ou triplicar a memória instantânea. Por isso, “tenho 8 GB de RAM” não equivale a “posso abrir centenas de imagens simultaneamente”. A concorrência precisa considerar o pico por trabalhador, não apenas o tamanho médio dos JPEGs em disco.
Eu registraria qualidade e transformações como atributos de observação: resolução, orientação, faixa dinâmica, saturação, contraste, desfoque e partes ausentes. Transformações para análise podem incluir uma versão reduzida e uma conversão de cor documentada. O arquivo preservado continua acessível por seu identificador, de forma que uma decisão possa ser revisada a partir da fonte correta.
Super-resolução e ampliação visual não fabricam evidência que estava ausente. Interpolação muda a representação da imagem; um modelo gerativo pode acrescentar detalhes plausíveis sem que eles tenham existido naquele registro. Para o problema científico descrito aqui, baixa qualidade precisa aumentar a incerteza e a possibilidade de abstenção, não incentivar uma aparência artificial de certeza.
8. Quatro terabytes: o relógio da pesquisa tinha som de HDD
Faço agora uma conta dimensional, com hipóteses expostas. Adoto 4 TB decimais = 4 × 10¹² bytes. Não trato TB e TiB como sinônimos: 4 TiB correspondem a 4 × 2⁴⁰ bytes, cerca de 10% a mais. Esse cuidado pequeno altera horas de leitura quando o conjunto é grande.
4 × 10¹² / (80 × 10⁶) = 50.000 s = 13,89 h
Esse é um limite idealizado de leitura sequencial a 80 MB/s. Ele não inclui busca mecânica, arquivos pequenos, metadados, cópia, descompressão ou competição entre processos. O valor de 80 MB/s é um parâmetro para a conta, não uma especificação atribuída aos discos que recebi. A análise de sensibilidade usa de 20 a 160 MB/s justamente para não transformar uma hipótese em um benchmark histórico.
Hashing, cópia verificada, geração de miniaturas e extração de descritores podem exigir novas passagens. Em um desenho ingênuo, cada experimento relê e decodifica tudo. Em um desenho mais cuidadoso, uma derivação compartilhada evita repetir trabalho, mas cria outros custos de armazenamento, catálogo e invalidação quando os parâmetros mudam.
Supondo uma média de 2 MB por imagem, 4 TB corresponderiam a dois milhões de imagens. Essa divisão não é a contagem original do acervo: serve para mostrar a ordem de grandeza. Se uma etapa consome dois CPU-segundos por imagem, ela exige quatro milhões de CPU-segundos. Em oito núcleos com eficiência global assumida de 65%, isso representa aproximadamente 213,7 horas de processamento.
T_CPU ≈ N × custo_CPU_por_imagem / (núcleos × eficiência)
T_CPU ≈ 2.000.000 × 2 / (8 × 0,65) = 213,68 h
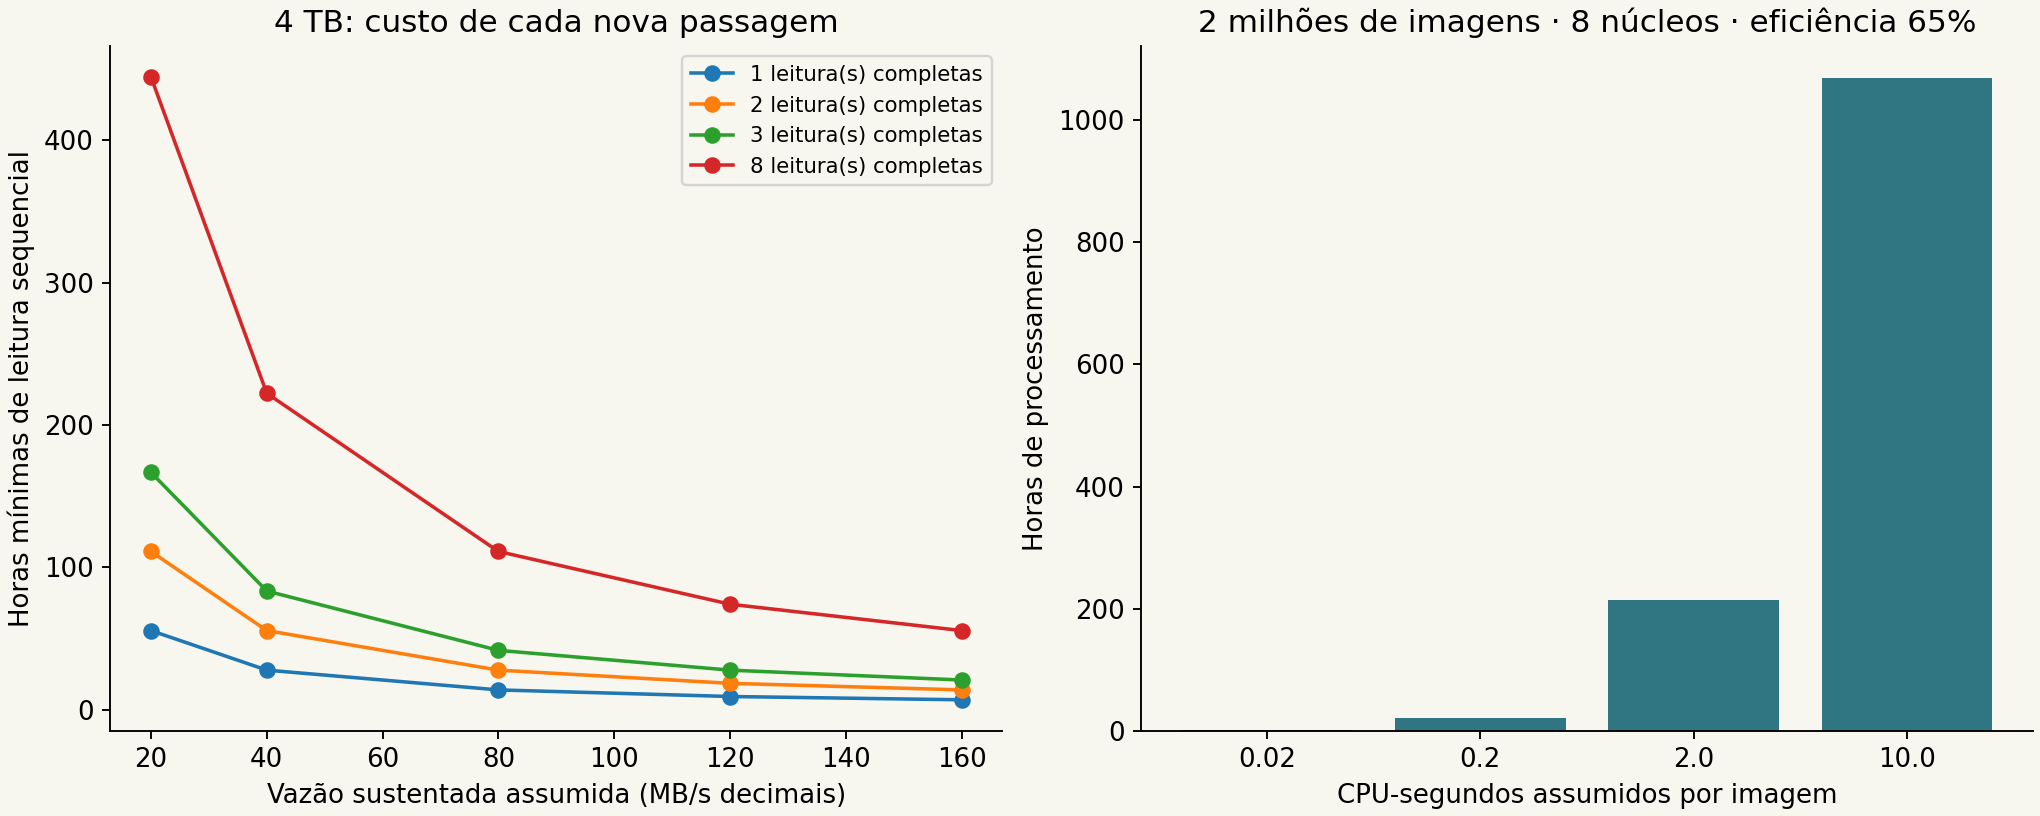
A vazão sustentada da pipeline é limitada pelo estágio mais lento: se cada estágio tem capacidade μᵢ, o teto simplificado é min μᵢ. A latência de uma imagem, por outro lado, inclui suas esperas e etapas sucessivas. Confundir vazão com latência leva a promessas como “oito núcleos tornam tudo oito vezes mais rápido”, que o disco e os trechos seriais podem desmentir imediatamente.
A lei de Amdahl ajuda a tornar essa restrição visível. Se uma fração s é serial e o restante paraleliza perfeitamente, o speedup com p núcleos é 1/[s + (1−s)/p]. Com s = 0,25, o limite assintótico é 4, ainda que eu acrescente núcleos indefinidamente. Descompressão compartilhada, catálogo sincronizado e I/O podem ampliar a parte que não escala.
A implementação também precisa controlar paralelismo aninhado. Oito processos, cada um solicitando oito threads de uma biblioteca numérica, podem produzir 64 threads disputando oito núcleos. Cache, largura de banda de memória e troca de contexto passam a consumir o ganho esperado. O experimento deve registrar concorrência de processos e threads, além do modelo da CPU.
9. Fazer a imagem caber em uma representação
Uma fotografia contém uma matriz de intensidades, não conceitos prontos. O descritor é uma escolha de quais variações eu quero preservar e quais quero atenuar. Se a representação elimina informação relevante, nenhum classificador posterior a recupera. Se preserva demais, pode memorizar câmera, borda, nome de pasta ou fundo em vez do padrão que me interessa.
Descritores globais resumem a imagem ou grandes regiões: histogramas de cor, textura, distribuição de bordas. São relativamente compactos, mas podem ignorar organização espacial. Descritores locais descrevem regiões ou pontos de interesse; permitem compor correspondências e suportar recortes, mas aumentam a quantidade de vetores e o custo de busca.
gradiente: gₓ = ∂I/∂x, gᵧ = ∂I/∂y
m = √(gₓ² + gᵧ²), θ = atan2(gᵧ,gₓ)
h_b = Σ_p m(p) × peso_do_bin_b(θ(p))
Um histograma conta distribuições, não reconstrói sozinho a cena. Duas imagens podem ter histogramas de cor parecidos e conteúdos muito diferentes. Um recorte pode remover o contexto responsável pela interpretação. Luz, compressão, pose, distância e resolução alteram características que o algoritmo mede, mesmo quando uma pessoa reconhece relações entre as cenas.
O HOG de Dalal e Triggs, de 2005, usa distribuições locais de orientação de gradientes com normalização de blocos. É uma referência importante para detecção de formas humanas, não um método que por si detecte exploração, nudez, faixa etária ou identidade. Sua utilidade depende de como a representação e o classificador são avaliados para a tarefa pretendida. [10]
normalização local reduz dependência de contraste;
não estabelece invariância a toda mudança de pose ou contexto
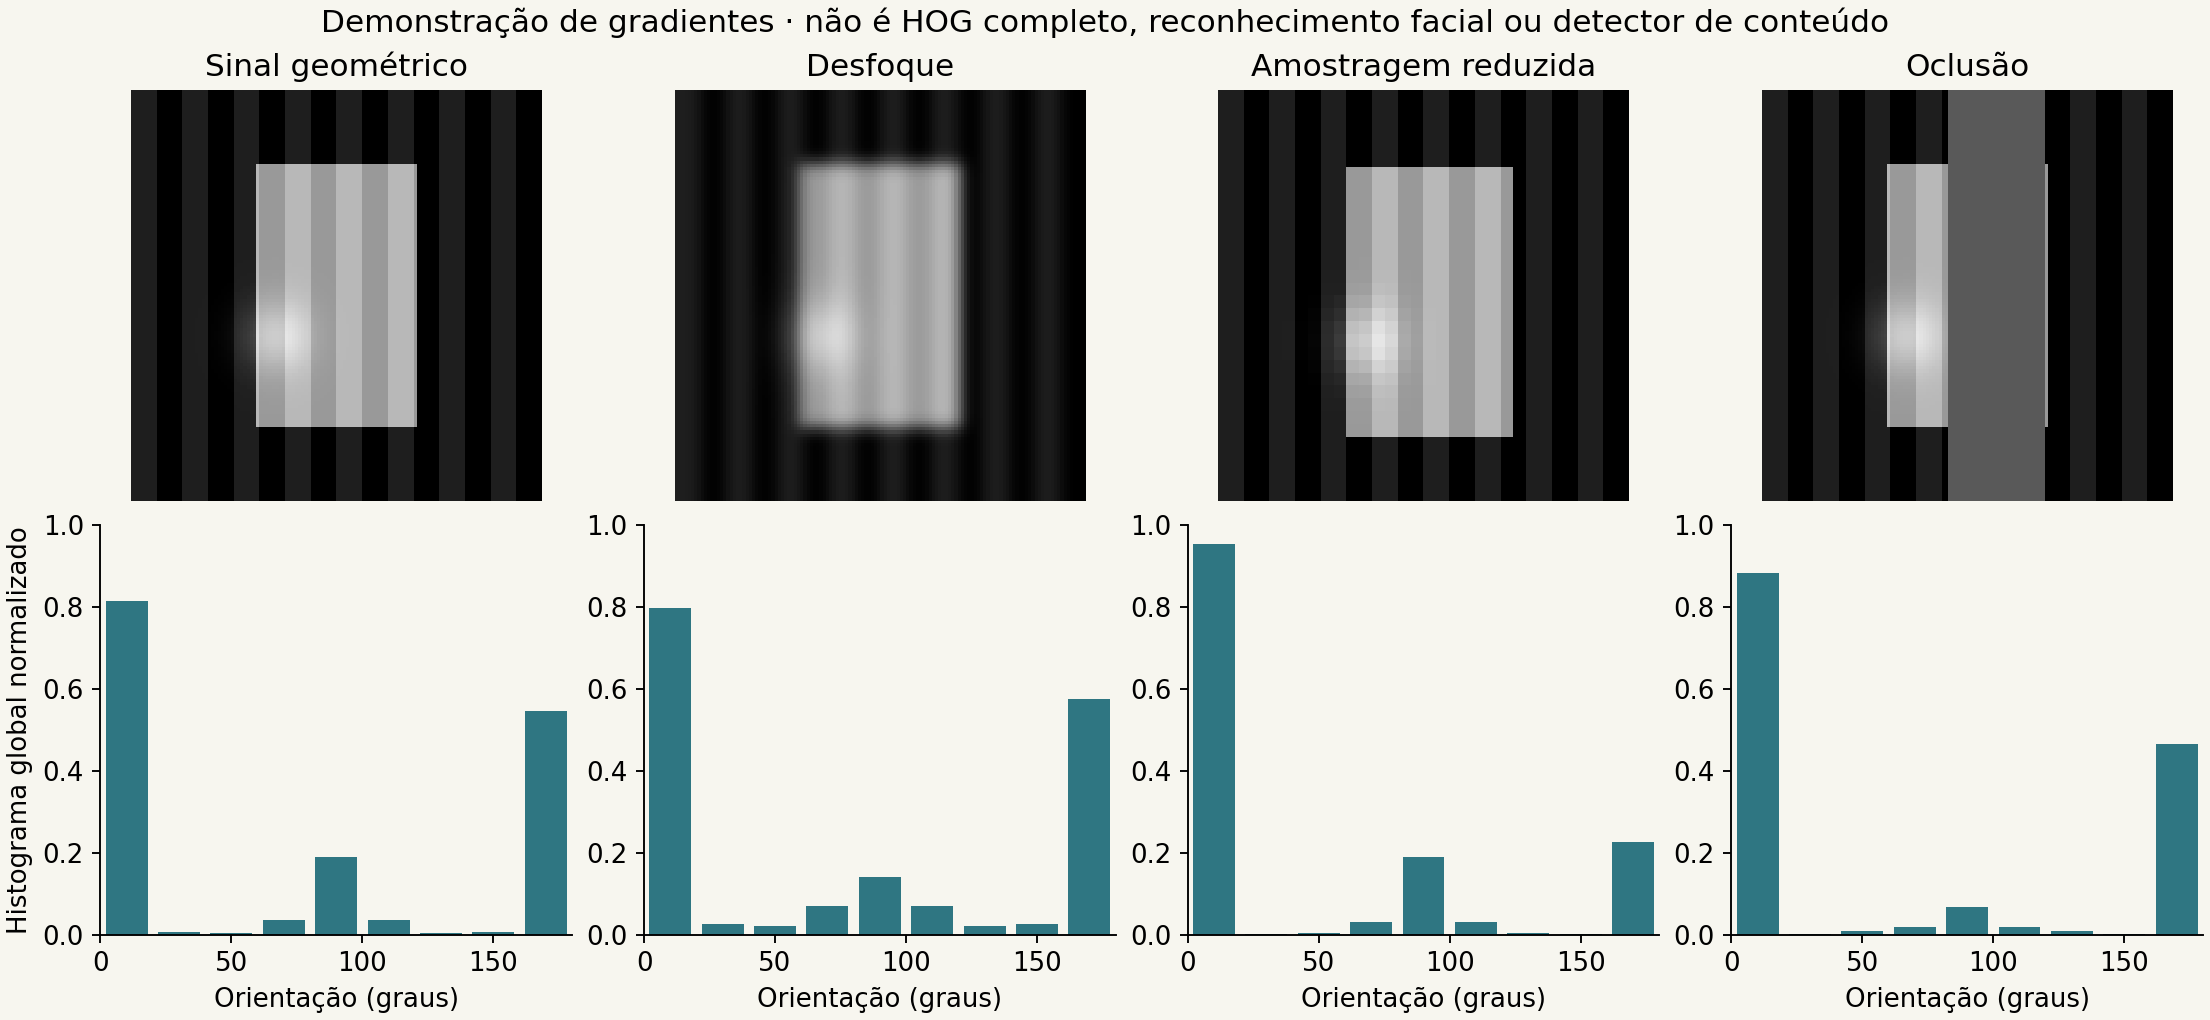
O SIFT de Lowe, em sua referência de 2004, procura pontos em espaço de escala e descreve vizinhanças com orientações de gradiente. A forma comum do descritor tem 128 componentes. A robustez a certas transformações não implica equivalência semântica: correspondências locais podem vir de uma textura ou fundo repetido. Sua verificação geométrica trata consistência de observações, não verdade sobre pessoas. [11]
O SURF, apresentado em 2006, combina um detector baseado em Hessiana com aproximações e imagens integrais para reduzir custo. Essa busca de eficiência era importante quando cada segundo de extração se multiplicava por milhões de arquivos. A comparação relevante seria qualidade de triagem por unidade de processamento, e não apenas a quantidade de pontos extraídos. [12]
ORB, de 2011, entra como continuação do período de pesquisa, com descritores binários e escolhas voltadas à eficiência. Em um descritor binário, a distância de Hamming conta bits diferentes; usar indiscriminadamente a distância euclidiana projetada para outro vetor muda o significado da comparação. Também não atribuo ORB a uma implementação de novembro de 2010. [13]
O descritor também podia consumir um terabyte
Se cada imagem produzisse mil descritores com 128 componentes em float32, seriam 512 mil bytes por imagem. Para dois milhões de imagens, somente os números ocupariam 1,024 TB decimais. Faltariam coordenadas, escalas, índices, identificadores e estruturas auxiliares. Reduzir pixels a descritores não garante automaticamente uma base pequena.
2.000.000 × 1.000 × 128 × 4 = 1,024 × 10¹² bytes
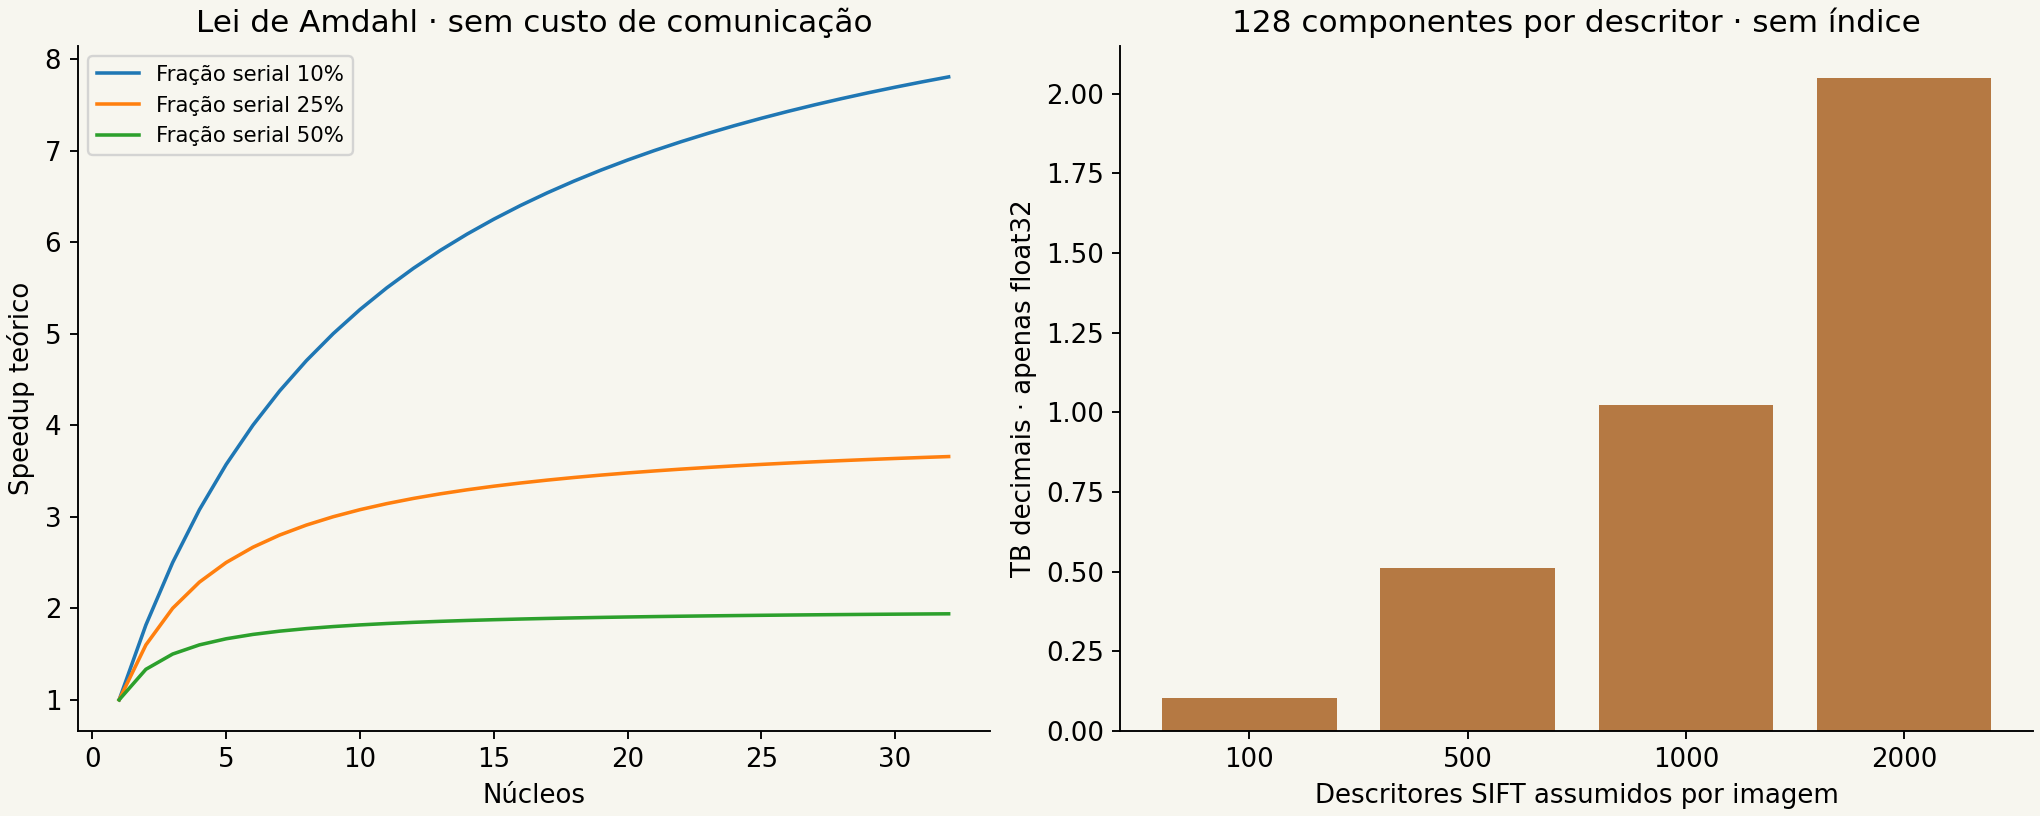
Eu precisaria decidir entre armazenar todos os vetores, agregar descritores, reduzir dimensionalidade e recalcular parte do trabalho. Essa decisão altera memória, tempo de consulta e rastreabilidade. Um índice aproximado pode acelerar vizinhos, mas deve preservar a possibilidade de recuperar o objeto e medir quando a aproximação perde candidatos relevantes.
10. Distância, normalização e o que o número realmente compara
Um vetor de cor, um vetor de textura e um histograma de gradientes não estão naturalmente na mesma unidade. Somar componentes sem escala pode fazer a característica numericamente maior dominar toda a comparação. A normalização deve ser ajustada no conjunto de treinamento e aplicada sem consultar o teste.
d₂(x,y) = √Σ_j (x_j − y_j)²
d_M(x,y) = √[(x−y)ᵀ Σ⁻¹ (x−y)]
d_χ²(h,g) = ½ Σ_j (h_j − g_j)² / (h_j + g_j + ε)
A distância de Mahalanobis pondera a geometria por uma covariância estimada, mas uma matriz quase singular exige regularização e pode ser mal estimada quando há muitas dimensões e poucos exemplos independentes. A distância qui-quadrado é uma opção para histogramas não negativos. Nenhuma delas pode ser chamada de “porcentagem de certeza” sem uma definição adicional e validação.
PCA pode projetar vetores para um subespaço: centralizo os dados, estimo uma base e retenho componentes. A variância preservada não é sinônimo de informação discriminante preservada. O fundo mais variável do corpus pode ocupar componentes principais enquanto o detalhe da classe de interesse ocupa pouca variância.
Σ U = U Λ; representação reduzida z = U_kᵀ(x−μ)
Uma busca por semelhantes pode apoiar deduplicação ou agrupamento para revisão. Mas três relações precisam continuar distintas: igualdade exata de bytes, semelhança visual entre arquivos e identidade de uma pessoa. Um hash exato resolve uma relação de bytes; um descritor responde a uma representação visual; identidade requer outro problema, outro protocolo e evidência apropriada. Não se pode atravessar essas fronteiras apenas trocando a legenda de uma coluna.
11. Treinar um classificador não era escrever uma regra para cada fotografia
A escolha manual de bordas e texturas não significa que toda a decisão fosse uma regra fixa escrita por mim. Era possível projetar uma representação e aprender uma fronteira estatística. Eu precisava definir o alvo de cada estágio: por exemplo, priorizar itens para uma revisão especializada. Uma classe de treinamento é uma convenção operacional documentada, não a totalidade de um fenômeno jurídico ou humano.
Uma SVM linear calcula f(x) = wᵀx + b. A aprendizagem ajusta w e b; o hiperplano não vem pronto do descritor. Na formulação com margem suave, o compromisso entre margem e violações é controlado por C. Kernels podem representar fronteiras não lineares, mas trazem outros custos de treinamento e predição. [14]
sujeito a y_i(wᵀx_i+b) ≥ 1−ξ_i; ξ_i ≥ 0
f_kernel(x) = Σ_i α_i y_i K(x_i,x) + b
Uma matriz de kernel densa com dois milhões de exemplos tem quatro trilhões de posições. Em float64, isso já significaria 32 TB para uma única matriz, antes do restante do treinamento. É uma conta de escala, não uma afirmação de que todo solver armazene essa matriz inteira: justamente por isso, decomposição, amostragem, métodos lineares e organização do problema importavam tanto.
Florestas aleatórias, com referência de 2001, ofereciam uma alternativa baseada em conjuntos de árvores e amostragem de características. Eram outra candidata para atributos heterogêneos, com avaliações de custo, memória e generalização específicas. Nem a votação das árvores nem a margem da SVM deveriam ser presumidas probabilidades calibradas. [15]
Eu compararia uma representação compacta e um classificador simples antes de aumentar a complexidade. Um modelo mais expressivo pode memorizar um vazamento mais depressa. Se as imagens de uma mesma origem aparecem nos dois lados da avaliação, melhorar a pontuação pode significar reconhecer o processo de organização do corpus, não aprender uma regra útil para novos casos.
12. O conjunto de dados começa nas decisões humanas
A unidade de anotação não deve ser uma pasta presumida como homogênea. Cada item recebe uma decisão, sua origem, a versão das instruções e o estado de revisão. Categorias diferentes respondem a perguntas diferentes: arquivo decodificável, conteúdo visual, necessidade de revisão e disponibilidade de contexto. Uma imagem incompleta não recebe automaticamente um rótulo negativo. Um item sem informação suficiente permanece indeterminado.
Um protocolo útil registra discordâncias e permite segunda leitura. Concordância bruta pode parecer excelente quando quase tudo pertence à classe majoritária. O coeficiente κ = (pₒ − pₑ)/(1 − pₑ) desconta a concordância esperada pelas frequências dos rótulos, mas também depende dessas frequências. Nenhuma dessas medidas transforma consenso em verdade jurídica. O objetivo é tornar o processo auditável e descobrir ambiguidades nas instruções.
A separação de treino, validação e teste precisa ocorrer por origem ou caso, após controlar duplicatas e derivações. Recortes, miniaturas e recompressões do mesmo arquivo não podem circular entre as partições. Ajustar o limiar no teste e apresentar esse mesmo teste como avaliação final produz uma estimativa otimista. O teste deve permanecer reservado até a definição do procedimento; mudanças posteriores exigem uma nova avaliação independente.
A proteção envolve acesso mínimo, registro de consultas e separação entre identificadores operacionais e dados descritivos. Não publico amostras do acervo nem detalhes que permitam reconstruir casos. A tarefa humana também tem custo: pausas, rotação, suporte e limites de exposição fazem parte da capacidade de revisão.
13. Conteúdo, idade, identidade e conclusão são perguntas distintas
Um detector de pele não é um detector de nudez; um detector de nudez não determina exploração; uma classificação visual não prova idade; e semelhança entre imagens não identifica uma pessoa. Fundo, iluminação, compressão, enquadramento e materiais de cor semelhante podem produzir falsos positivos. Um sistema que confunde essas etapas converte uma hipótese estatística em uma afirmação que o dado não sustenta.
A aparência não estabelece uma idade exata, especialmente junto a um limite legal. Também não autoriza inferir que uma pessoa é menor de idade por tamanho, pose ou resolução. O encaminhamento de um item para análise é uma decisão de priorização, sujeita à avaliação qualificada e ao contexto disponível. Material inconclusivo deve conservar sua incerteza no relatório.
No meu registro, a engenharia deveria reduzir o universo de busca sem substituir a responsabilidade humana. Isso exige classes de abstenção e rastreabilidade das razões de encaminhamento. Uma saída curta como “positivo” elimina informações essenciais: qualidade da entrada, versão do modelo, população de validação, limiar utilizado e motivo da revisão.
14. CNNs: representação aprendida e orçamento de operações
Redes convolucionais já tinham uma base consolidada antes deste período, como LeNet [16]. Uma convolução calcula yᵢⱼₖ = bₖ + Σᵤᵥ꜀ wᵤᵥ꜀ₖ xᵢ₊ᵤ,ⱼ₊ᵥ,꜀. O compartilhamento de pesos reduz parâmetros em comparação com uma ligação densa sobre todos os pixels. Entretanto, cada posição espacial ainda exige operações. Pooling reduz a resolução e altera a sensibilidade a pequenos deslocamentos; não garante invariância a qualquer transformação.
Para convolução sem preenchimento e passo um, Hₒ = Hᵢ − K + 1, e o número de multiplicações-acumulações é HₒWₒCₒK²Cᵢ. Uma rede ilustrativa em escala de cinza, com seis filtros 5×5, pooling 2×2 e depois dezesseis filtros 5×5, exige 357.600 MACs para entrada 32×32 e 10.380.000 para 128×128, apenas nas convoluções do avanço. Treino acrescenta gradientes, armazenamento de ativações e atualizações de parâmetros. MAC não é uma unidade de tempo de CPU.
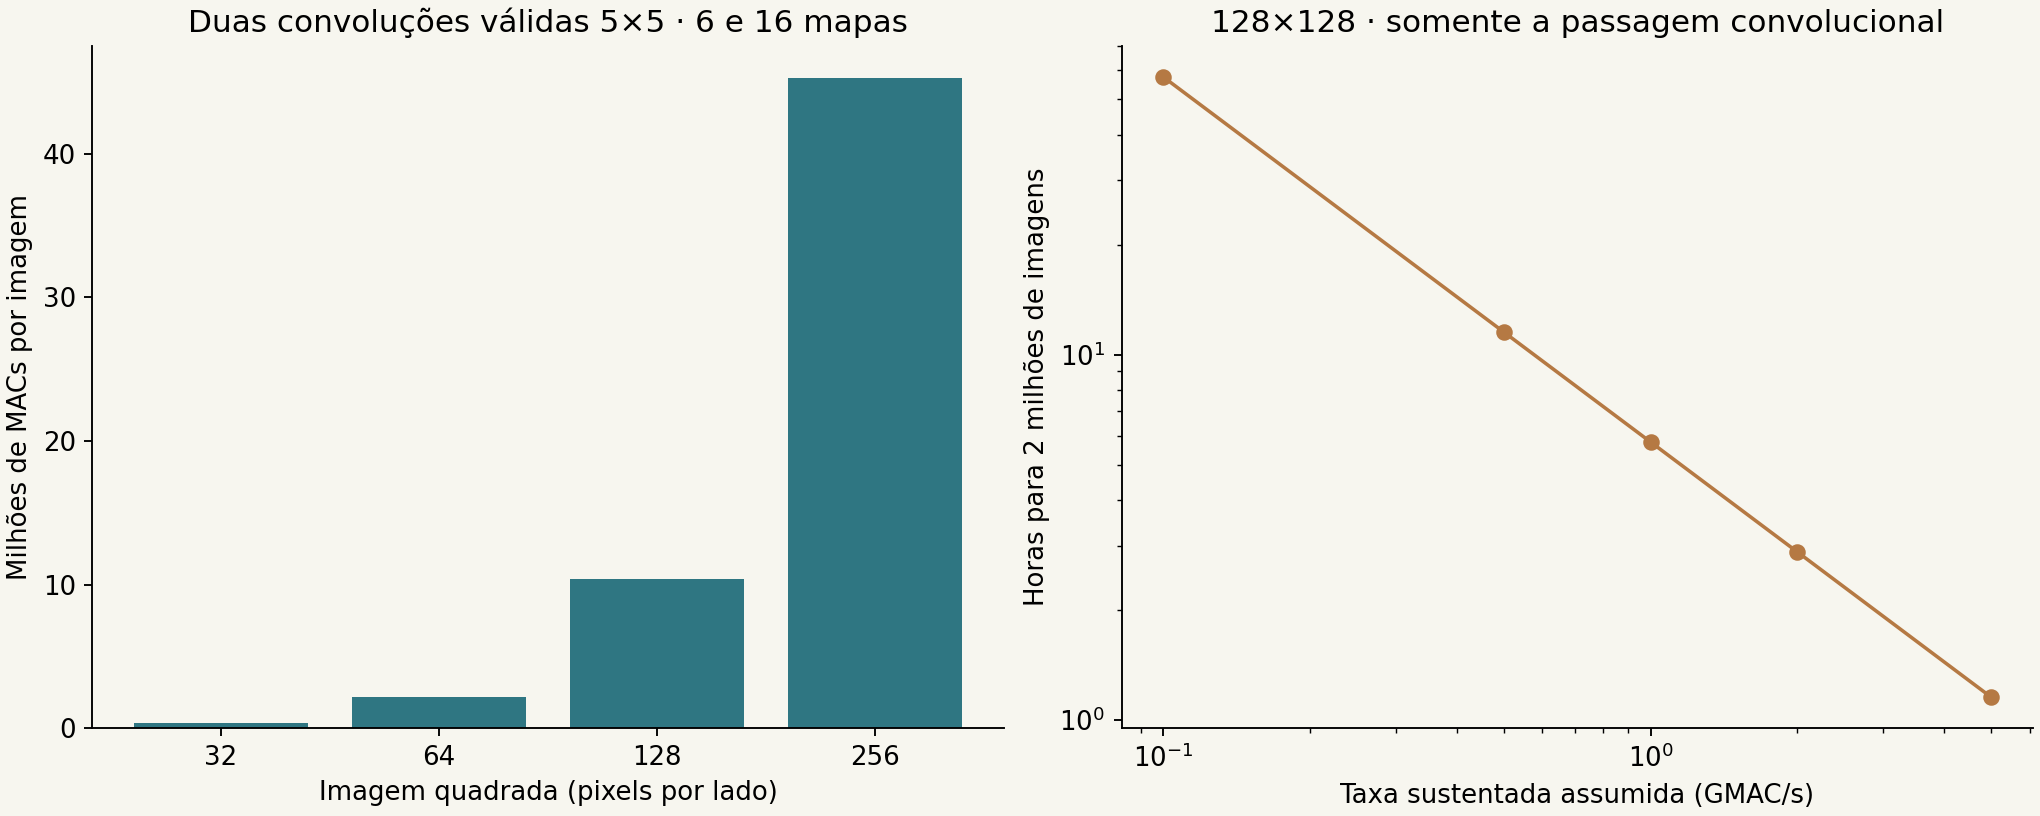
Uma função de perda, como entropia cruzada, orienta o aprendizado; não resolve por si a qualidade da anotação nem o deslocamento entre origens. Uma rede pequena podia ser uma alternativa experimental, junto a descritores e classificadores tradicionais. Pesquisas com GPU em 2011 já demonstravam a importância da implementação paralela [5]. Não seria correto dizer que GPU ou CNN não existiam; o limite prático era o conjunto de dados, ferramentas, infraestrutura e tempo de engenharia disponível.
15. Margem, probabilidade e abstenção
A saída de um SVM é uma margem, não uma probabilidade. A transformação sigmoidal P(y=1|f) = 1/(1 + exp(Af+B)), associada ao método de Platt e à implementação discutida por Lin e colaboradores [17], aprende A e B usando dados separados. Calibração requer uma amostra representativa e sem vazamento de origem. Uma função que devolve 0,9 não significa automaticamente 90% de acerto para qualquer população.
O escore de Brier, média de (pᵢ−yᵢ)², permite avaliar previsões probabilísticas; gráficos de confiabilidade comparam frequências observadas e médias previstas. Separar os dados em poucos intervalos esconde detalhes; intervalos demais ficam instáveis. Uma curva bonita pode resultar de uma amostra pequena, de duplicatas ou de uma distribuição que não representa a próxima entrada.
Dois limiares podem distinguir regiões de baixa prioridade, revisão e revisão prioritária. Isso não equivale a liberar automaticamente arquivos abaixo de um valor. Falhas de decodificação, formatos desconhecidos e baixa qualidade seguem uma rota de exceção. Os limiares dependem da finalidade, do custo dos erros, da capacidade de revisão e da avaliação autorizada. Os valores a seguir servem exclusivamente à demonstração matemática.
16. Quando 95% de sensibilidade ainda produz uma fila ruim
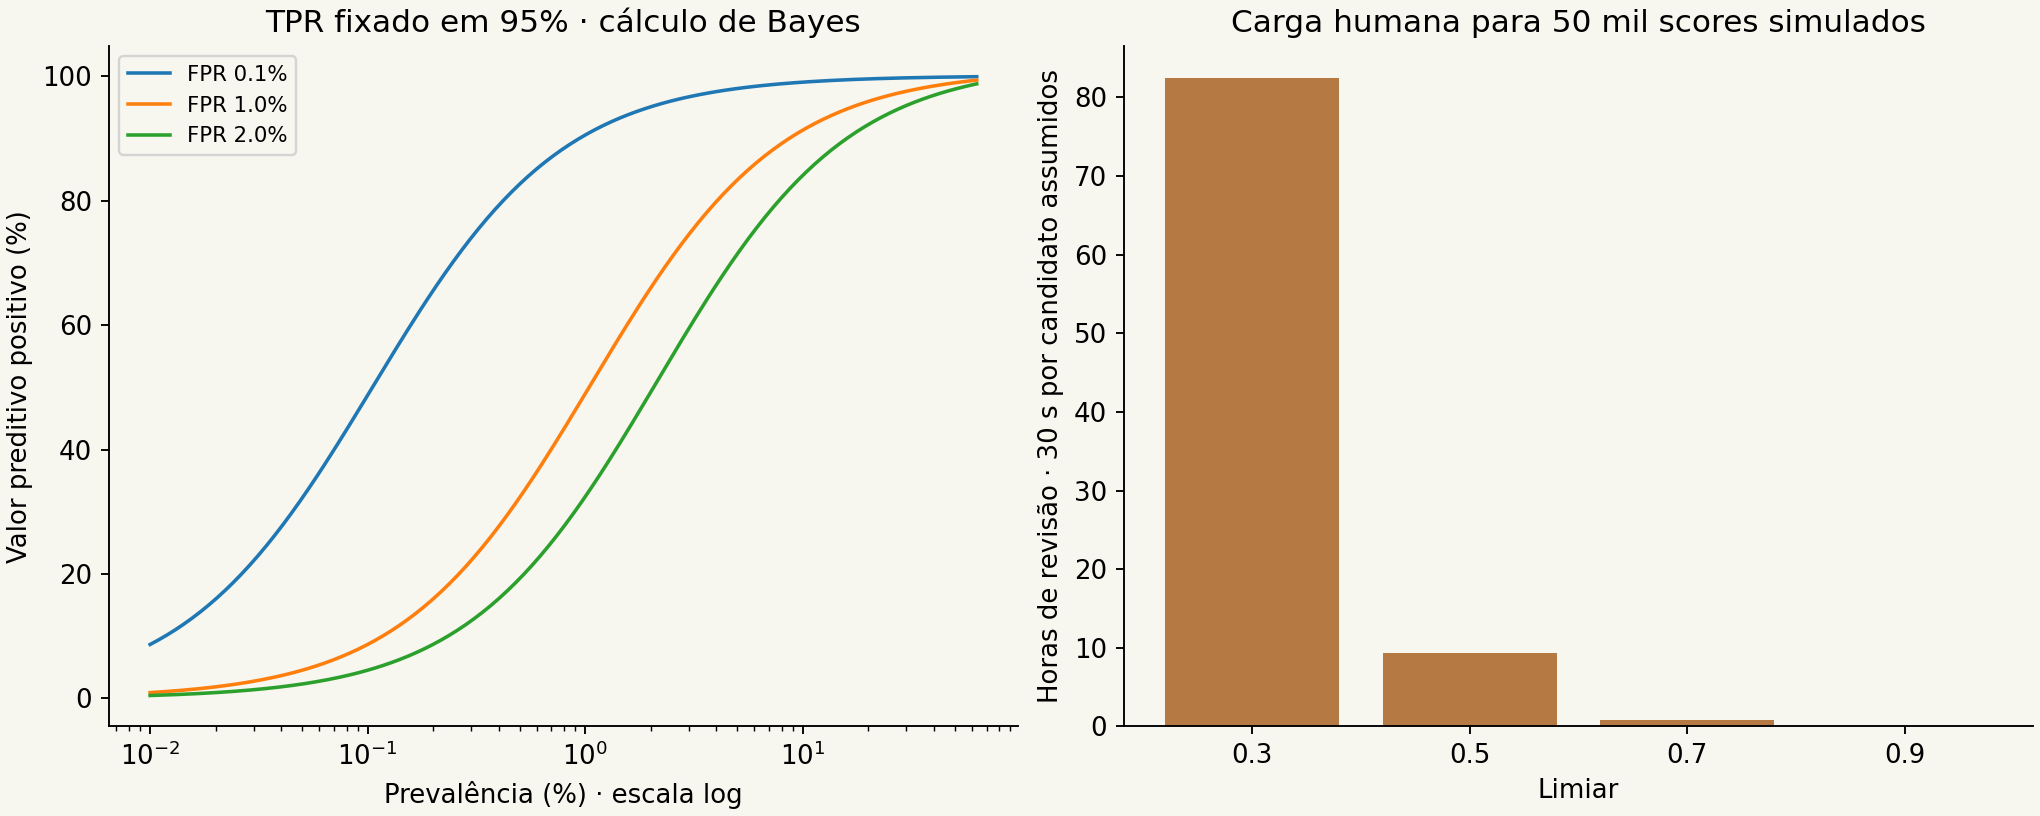
Defino sensibilidade como TP/(TP+FN), taxa de falso positivo como FP/(FP+TN) e precisão como TP/(TP+FP). A precisão depende da prevalência π: PPV = TPR·π / [TPR·π + FPR·(1−π)]. Se π = 0,001, TPR = 0,95 e FPR = 0,02, a precisão esperada é aproximadamente 4,54%. A maioria dos encaminhamentos seria falsa, embora a sensibilidade isolada pareça alta.
Para visualizar esse efeito sem utilizar imagens sensíveis, o suplemento gera 50.000 escores numéricos: 250 positivos analíticos e 49.750 negativos. São amostras de distribuições beta com semente 2010, sem treinamento e sem imagens. O experimento não mede o trabalho histórico, uma ferramenta forense ou a prevalência de qualquer acervo.
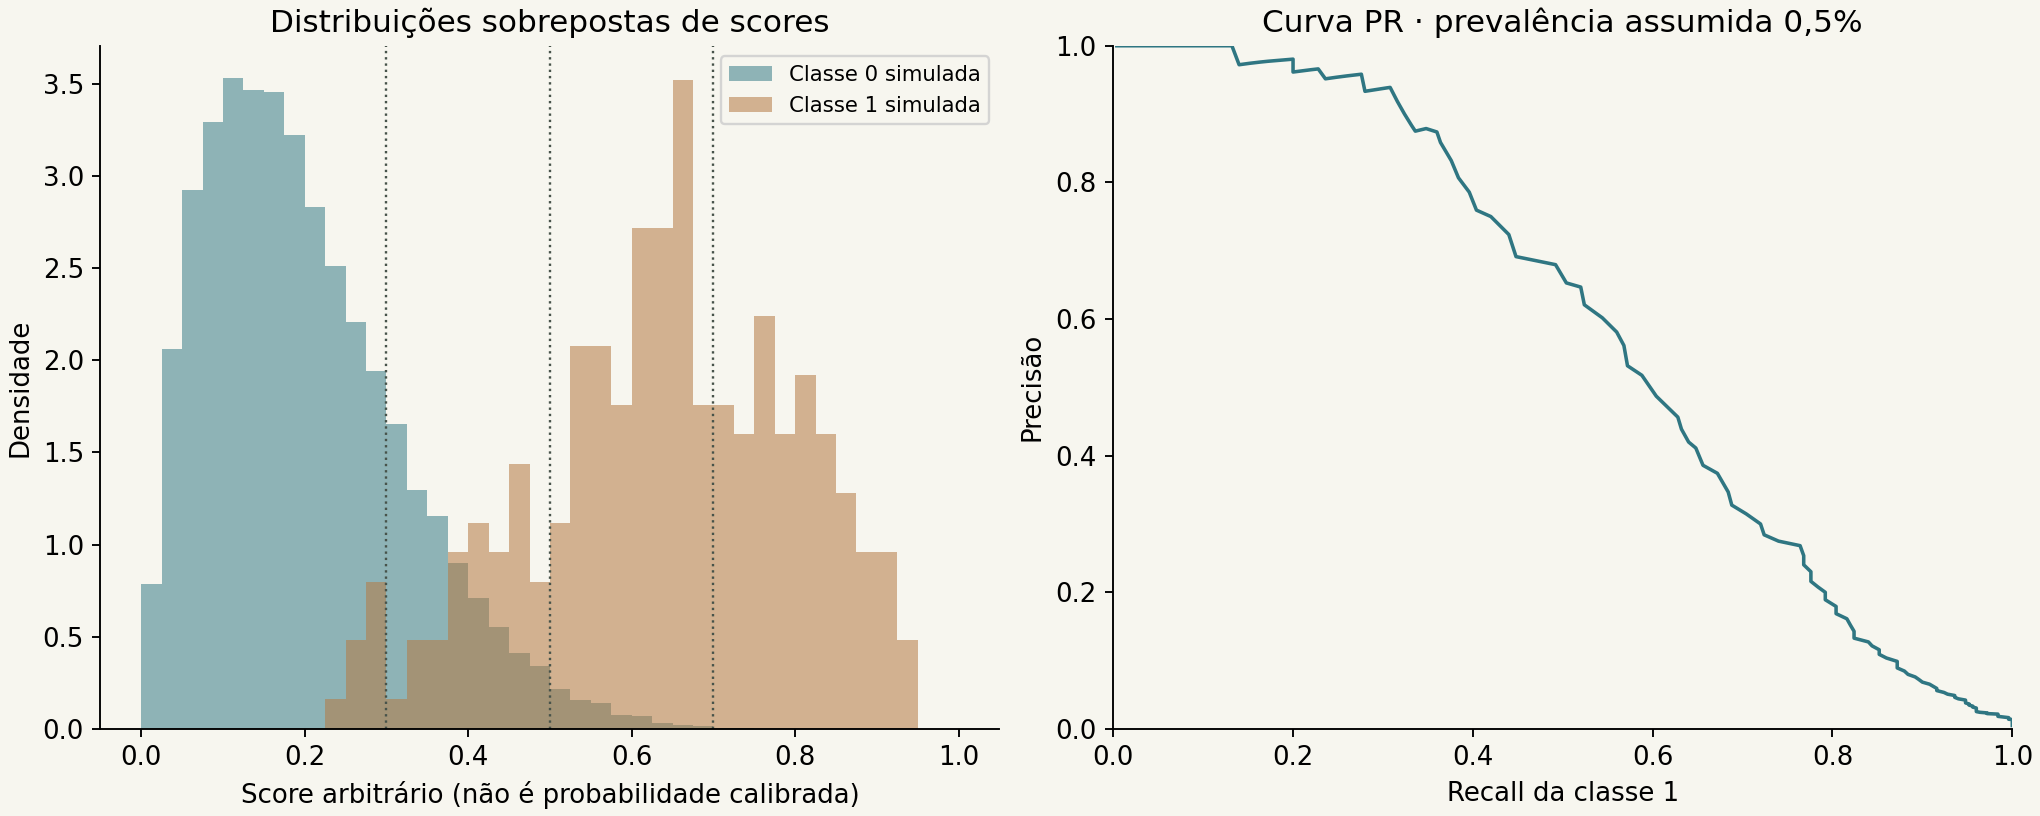
| Limiar | TP | FP | FN | Precisão | Fila |
|---|---|---|---|---|---|
| 0,3 | 241 | 9.653 | 9 | 2,44% | 9.894 |
| 0,5 | 201 | 920 | 49 | 17,93% | 1.121 |
| 0,7 | 90 | 13 | 160 | 87,38% | 103 |
| 0,9 | 9 | 0 | 241 | 100% nesta amostra | 9 |
O último resultado não prova ausência de falsos positivos na população. Ele coincide com a perda de 241 dos 250 positivos gerados. Divulgar somente “100% de precisão” esconderia o principal custo. Intervalos de incerteza, denominadores e composição do teste precisam acompanhar a avaliação.
17. A fila humana é um recurso finito
Com trinta segundos por item, os 9.894 encaminhamentos da primeira linha exigiriam 82,45 horas de revisão ininterrupta; 1.121 exigiriam 9,34 horas. O cálculo não inclui pausas, segunda leitura ou busca de contexto. A taxa de chegada λ precisa ser comparada à capacidade efetiva de atendimento μ. Quando λ permanece acima de μ, a fila cresce, independentemente da velocidade de extração dos descritores.
Por isso, devo observar quantidade de itens em espera, idade dos itens, formatos rejeitados e revisão por origem. Uma mudança de distribuição pode aumentar a fila sem que o software apresente uma falha explícita. Atualizar o modelo ou alterar o limiar exige preservar a versão anterior e registrar o que mudou. Uma avaliação auditável não apaga decisões anteriores para apresentar apenas a configuração mais favorável.
18. Registro pessoal: 2012 e 2022
Estas quatro fotografias são minhas, fornecidas e identificadas por mim. As duas de camisa social/polo são de 2012; as duas de regata são de 2022. Elas compõem um registro pessoal posterior ao recorte de estudo de 2010–2011. Não são amostras do acervo e não foram utilizadas nos cálculos deste artigo.
Iluminação, roupas, enquadramento e passagem do tempo ilustram por que comparação visual exige contexto. Não apresento reconhecimento facial, estimativa etária ou percentual biométrico dessas fotos. A atribuição e as datas são declarações minhas. A distância entre dois vetores pode medir uma representação; não se converte, por uma simples regra de três, em probabilidade de duas pessoas serem a mesma.
19. Um procedimento verificável, sem revelar a implementação reservada
- Registrar escopo autorizado, recebimento, integridade e responsáveis.
- Trabalhar sobre cópias e manter vínculo verificável com a origem.
- Extrair objetos de fluxos disponíveis, registrando lacunas e limitações.
- Inventariar contêineres e aplicar limites de profundidade, volume e tempo.
- Decodificar em ambiente isolado e distinguir falha de resultado negativo.
- Medir qualidade e produzir descritores com configuração versionada.
- Avaliar modelos com partições por origem e teste reservado.
- Registrar escores, calibração aplicável, limiar e rota de exceção.
- Encaminhar para revisão qualificada, preservando discordâncias.
- Relatar evidência, decisões e limites, sem transformar prioridade em conclusão.
para cada objeto autorizado:
    registrar_origem_e_integridade(objeto)
    resultado = extrair_com_orcamento(objeto)
    se resultado.incompleto:
        registrar_excecao(resultado)
        continuar
    imagem = decodificar_isoladamente(resultado)
    se imagem.falhou:
        registrar_excecao(imagem)
        continuar
    registrar_qualidade_e_versoes(imagem)
    encaminhar_conforme_protocolo_de_revisao(imagem)
Este pseudocódigo descreve responsabilidades, não a solução completa que foi implementada. Chaves, casos, regras reservadas, configurações internas e patentes permanecem protegidos. Nenhum trecho habilita acesso a redes ou acervos de terceiros.
20. O que veio depois — cronologia separada
AlexNet, de 2012 [18], tornou particularmente visível a combinação de redes convolucionais, dados e GPU em classificação. ResNet apareceu como preprint em 2015 e publicação de conferência em 2016 [19]. Vision Transformer surgiu em 2020, com publicação em 2021 [20]; CLIP é de 2021 [21]. Não atribuo essas tecnologias ao trabalho de novembro de 2010.
Representações posteriores ampliam possibilidades de transferência e busca, mas exigem avaliação específica para a tarefa. A avaliação de estimativa etária do NIST, publicada em 2024 [22], pertence a esse comentário posterior: qualidade e população de teste continuam sendo relevantes. Ela não valida retrospectivamente um sistema de 2010 e não transforma aparência em comprovação de idade.
21. Suplemento analítico para executar em casa
O pacote contém Python, tabelas e instruções para regenerar as sete figuras. Ele trabalha com equações, distribuições numéricas e um sinal geométrico. Não contém fotografias pessoais, imagens do acervo, captura de rede, reconhecimento facial ou um detector de conteúdo. As versões de bibliotecas informadas são do ambiente atual de execução do suplemento; não são atribuídas ao ambiente de 2010.
Baixar Python, gráficos e tabelas ↓
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python figures.py
python verify.py
As hipóteses são editáveis: capacidade de leitura, quantidade estimada de imagens, custo de CPU, eficiência paralela e tempo por revisão. Ao alterá-las, o leitor produz outro cenário de capacidade, não uma medição do caso histórico.
22. Conclusão: reduzir a busca e conservar a dúvida
O problema que recordo não se resumia a escolher um classificador. Quatro terabytes significavam leitura, cópias, contêineres, decodificação, descritores, memória, filas e pessoas. Uma melhoria local podia deslocar o gargalo para a etapa seguinte. Uma métrica aparentemente alta podia produzir uma fila impraticável ou esconder falsos negativos.
O valor científico está em explicitar as unidades, separar hipóteses de medições e conservar a origem de cada decisão. Este é parte de um registro histórico pessoal. Apresento técnicas disponíveis ou desenvolvidas para aquele problema, sem divulgar integralmente sua implementação. Pessoas, empresas, informações confidenciais e patentes estão devidamente resguardadas e pertencem aos respectivos titulares, assim como minhas patentes.
Referências e créditos
- Falcão — Image Foresting Transform, bibliografia do autor ↗
- OpenCV — histórico de versões ↗
- LIBSVM — versões históricas ↗
- OpenMP 3.0 — especificação, 2008 ↗
- Cireșan et al. — Flexible, High Performance Convolutional Neural Networks, 2011 ↗
- NIST SP 800-86 — Guide to Integrating Forensic Techniques into Incident Response, 2006 ↗
- RFC 793 — Transmission Control Protocol, 1981 ↗
- RFC 1952 — GZIP file format, 1996 ↗
- Library of Congress — 7z format description ↗
- Dalal e Triggs — Histograms of Oriented Gradients, 2005 ↗
- Lowe — Distinctive Image Features from Scale-Invariant Keypoints, 2004 ↗
- Bay, Tuytelaars e Van Gool — SURF, 2006 ↗
- Rublee et al. — ORB, 2011 ↗
- Cortes e Vapnik — Support-Vector Networks, 1995 ↗
- Breiman — Random Forests, 2001 ↗
- LeCun et al. — Gradient-Based Learning Applied to Document Recognition, 1998 ↗
- Lin, Lin e Weng — A Note on Platt’s Probabilistic Outputs for Support Vector Machines ↗
- Krizhevsky et al. — ImageNet Classification with Deep Convolutional Neural Networks, 2012 ↗
- He et al. — Deep Residual Learning, 2015/2016 ↗
- Dosovitskiy et al. — An Image Is Worth 16×16 Words, 2020/2021 ↗
- Radford et al. — Learning Transferable Visual Models, 2021 ↗
- NIST IR 8525 — Face Analysis Technology Evaluation: Age Estimation and Verification, 2024 ↗
Fotografias pessoais: Klyff Harlley Toledo, datas e autoria informadas pelo autor. O relato do recebimento do material da Polícia Federal é uma declaração histórica do autor; este artigo não apresenta dados de casos ou documentos reservados.